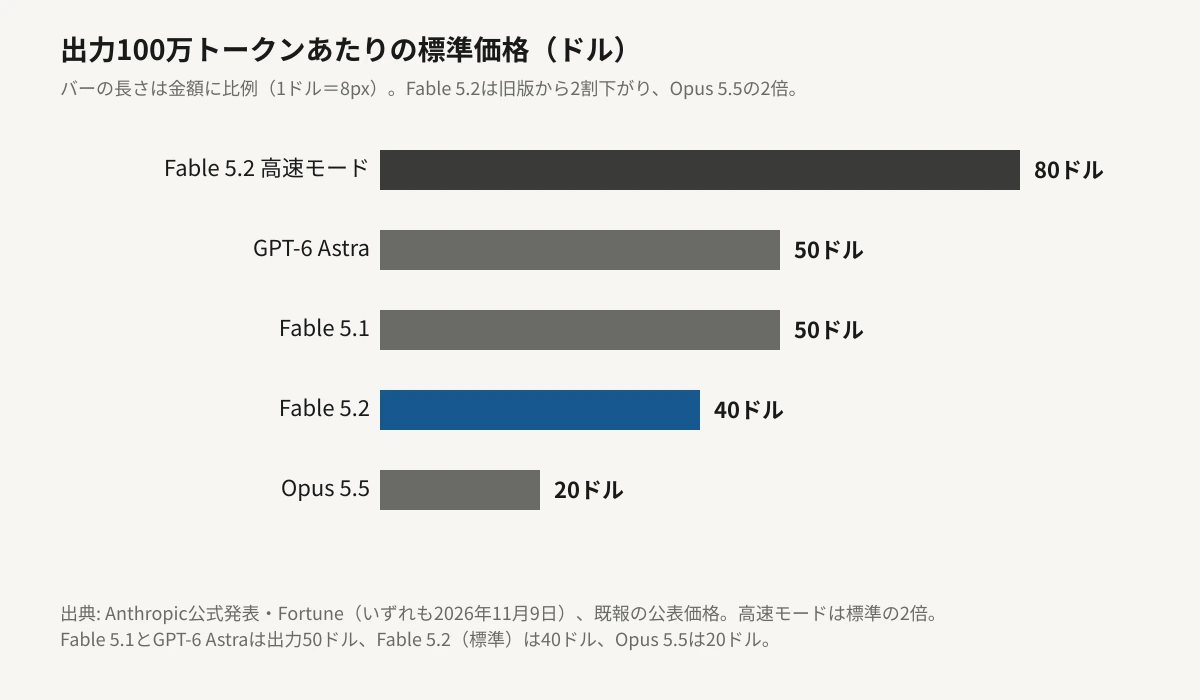
Anthropic が11月9日、最上位モデルの新版「Claude Fable 5.2」と、同じ中身を審査済みの組織だけに開く「Claude Mythos 5.2」を発表した。標準価格は入力100万トークンあたり8ドル、出力40ドル。9月に出た前の版Fable 5.1(入力10ドル・出力50ドル)から、入出力とも20%下がっている。
値下げと同時に、性能の自己申告値は大きく伸びた。コーディングの指標FrontierCode 2.0でFable 5.1の32.4%から49.1%へ。第三者のArtificial Analysisの一覧でも、Fable 5.2(max)は65点で首位に立っている。
ただし、これで話が終わるわけではない。安くなっても、Fable 5.2の単価はAnthropicが「まず選ぶ」と薦めるOpus 5.5の2倍のままだ。選ぶ側にとって問いは「Fableが強くなったか」ではなく、「その2倍を払うだけの仕事が自分にあるか」に移っている。前の版の経緯はClaude Fable 5.1の記事で伝えた。この記事では、5.2で新しく動いた点に絞る。
⚠ 情報の鮮度について
一次情報はAnthropicの公式発表(2026年11月9日)と、同日のFortuneの報道です。本記事は発表から約1日後の時点で書いています。ベンチマークの数値はAnthropic自身の測定で、第三者が再現した値ではありません。Artificial Analysisの指数だけが独立した測定です。価格はすべて開発者向けAPIの公表価格で、ClaudeやChatGPTの月額プランの価格ではありません。
Section 01
Claude Fable 5.2とは──何が出て、いくらになったのか
Fableは、Claudeの最上位ラインだ。9月の5.1に続く今回の5.2は、FableとMythosの2本が同時に新しくなった。API上のFable 5.2のモデルIDは claude-fable-5-2 で、AWS・Google Cloud・Microsoft Azureを含む各プラットフォームで使える。
動いたのは価格の表だ。標準価格は2割下がり、さらにFableでは新しく「高速モード」が加わった。標準の2倍の料金で、出力が最大2.5倍の速さになる。
| 100万トークンあたり | Fable 5.1 | Fable 5.2 | 変化 |
|---|---|---|---|
| 入力 | 10.00ドル | 8.00ドル | −20% |
| 出力 | 50.00ドル | 40.00ドル | −20% |
| キャッシュ読み取り | 0.25ドル | 0.20ドル | −20% |
| 高速モード(入力/出力) | なし | 16.00ドル/80.00ドル | 標準の2倍 |
キャッシュ読み取りとは、同じ前置きの文章を繰り返し読ませるときに安く処理される仕組みの単価だ。長い作業を何度も往復させるエージェント型の使い方では、入出力より請求の中身を左右することがある。
競合との位置関係も押さえておく。Fortuneによると、OpenAI(ChatGPTの提供元)の最上位モデルGPT-6 Astraは入力10ドル・出力50ドル、キャッシュ読み取り1ドル。Fable 5.2はこれより標準単価で20%安く、キャッシュ読み取りでは0.20ドルと80%安い。Fable 5.1までは、標準単価がAstraと同額だった。
20%
入力・出力・キャッシュ読み取りの値下げ幅
2.5倍
高速モードの出力速度(最大・料金は2倍)
30%
標準モードでも5.1より速くなった幅(最大・Anthropic自己申告)
一言でまとめると──「最上位の値札が下がり、速さも上がった。ただし『安くなった』より先に、Opus 5.5と比べて2倍かかる点を見てください」。値下げ幅の大きさより、どの仕事をFableに回すかの線引きのほうが、請求額を左右します。
Section 02
同じモデルで入口だけ違う──FableとMythosの分かれ目
Anthropicの説明では、FableとMythosは同じ土台のモデルだ。違いは、サイバーと生物学の領域に安全装置(分類器)がかかっているかどうかにある。
A
Fable 5.2:誰でも使えるが、一部の仕事は止まる
侵入テスト、攻撃コードの生成、バイナリの脆弱性調査といった危険度の高いサイバー作業と、研究用途の生物学の大半は分類器が止める。止まった質問は、サイバーならOpus 4.8、生物学ならOpus 5が代わりに答える。
B
Mythos 5.2:安全装置なし、ただし審査済みの組織だけ
使えるのは、Anthropicのサイバー検証プログラムか、ライフサイエンス検証プログラムを通った組織に限られる。Claude Enterpriseの顧客は、検証がなくても「Claude Security」を使える。Mythos 5.2を含むClaudeのモデル一式で動く製品だ。
C
5.2で変わったのは「止まる頻度」
Anthropicによると、Fable 5.2が止める量は5.1より全体で約55%少ない。内訳はサイバーで約60%、生物学で約40%。誤って止められる仕事が減ったという主張だ。
この仕組みの経緯は、Cyber Verification Programが3段階になった件で扱った。ここでの要点は、普通の開発・分析・文章の仕事なら、FableとMythosで使い心地は変わらないことだ。分かれ目が出るのは、脆弱性を探す、攻撃を再現する、実験系の生物学を扱うといった、はっきり限られた領域に入ったときだけになる。
安全面でAnthropicが数字を出した点がひとつある。作業用の環境(サンドボックス)から外へ抜け出そうとする挙動を、1,800超の場面で調べた試験だ。Mythos 5.2の発生率は3.1%で、Mythos 5.1の21%、Mythos 5の39%から大きく下がった。同じ試験でOpus 5.5は3.3%だった。ただし、これはAnthropic自身の試験で、第三者が再現した値ではない。※観測として読むのが妥当だ。過去に起きた事案はClaude Mythos 5の偽の身元の件にまとめてある。
Section 03
性能はどこまで上がったか──自己申告と第三者の数字
まずAnthropicが公表した比較表のうち、選ぶ人に関係しそうな行を抜き出す。すべてAnthropic自身の測定で、モデルごとに推論の強さの設定(effort)が異なる行もある。Gemini 4 CarbonのFrontierCodeはmedium、Fable 5.2はxhighでの値だ。
| 指標 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0(コード) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2(実開発) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| OSWorld 2.1(パソコン操作) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| AutomationBench(業務の自動化) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| AA-Briefcase(Elo) | 1785 | 1669 | 1800 | 1569 | 1611 |
| Remote Labor Index(実務の丸ごと受注型) | 41.3% | 17.9% | 21.3% | 20.8% | 非掲載 |
読み取れることは3つある。第一に、Fable 5.1からの伸びが大きい。FrontierCodeでは16.7ポイント、Remote Labor Indexでは17.9%から41.3%へ2倍超になった。第二に、Opus 5.5との差は指標で大きく違う。OSWorldでは2.1ポイント、FrontierSWEでは7.6ポイントで、一方的な差とまでは言えない。第三に、Fableが負けている行もある。AutomationBenchはGemini 4 Carbonが53.9%で上、AA-BriefcaseのEloはOpus 5.5が1800でわずかに上だ。
独立した測定も見ておく。Artificial Analysisの一覧(11月10日時点)では、Fable 5.2(max)が65点で首位。続いてFable 5.2(xhigh・high)が62点、Gemini 4 Carbon(high)が60点、Opus 5.5(max)が59点、GPT-6 Astra(max)が57点という並びだった。首位とはいえ、その差はGemini 4 Carbonに5点、Opus 5.5に6点。「抜けた」というより「一段上に出た」と読める幅になる。
ⓘ 「max」の65点と、日常の設定は別物です
首位の65点は、推論の強さを最大(max)にしたときの値です。同じFable 5.2でも、xhighやhighでは62点でした。強さを上げるほど答えは良くなりますが、そのぶん考えるために使うトークンも増え、請求額に響きます。Anthropicの資料でも、Claudeのアプリとコーディング支援ツールの既定はmediumとされています。数字を見るときは、どの設定の点かを必ず確かめてください。
Section 04
Fable 5.2の料金で、あなたはどれを選ぶか
Anthropic自身の案内は、意外なほど控えめだ。ほとんどのコーディングと知的作業は、まずOpus 5.5から始める。そのうえで、最も野心的で答えの決まっていない仕事ではFableかMythosへ上がり、軽い仕事ではSonnet 5.5かHaiku 5.5へ下がる、という使い分けを示している。
この案内に価格を当てはめると、考え方がはっきりする。Opus 5.5は入力4ドル・出力20ドルで、Fable 5.2はちょうどその2倍。同じ仕事をやらせたとき、Fable 5.2のほうが1回の請求が必ず大きくなるわけではないが、単価の土台が2倍あるぶん、仕事の側にそれを取り返す理由が要る。理由があるのは、たとえば次のような場面だ。
01
Fable 5.2に回してよい仕事
長時間、人手を離れて動かす大きな作業。複数ファイルにまたがる移行や、答えのない調査。やり直しの1回が高くつく仕事ほど、最上位に払う理由になる。
02
Opus 5.5のままでよい仕事
日常のコード修正、文書の下書き、レビュー。Anthropicの比較表でも差が数ポイントにとどまる領域で、価格が半分のOpus 5.5で足りる場面が多いと考えられる。
03
高速モードは「待ち時間が人件費」の場面だけ
料金は標準の2倍、出力量が増えるぶん請求も膨らむ。人が画面の前で待ち続ける対話型の作業に限るのが無難だ。夜間の一括処理には向かない。
月額プランで使う人は、API価格とは別の話になる。Anthropicの案内では、今週に限りProと標準のTeam席で、Fableが週の利用上限の最大50%まで使える。MaxやUltra、上位のTeam席には、契約期間に応じて1〜3回のFable用の上限リセットが付く。Ultra(月200ドル)の上限の仕組みは先日整理した。ProとTeamの標準シートの期限は太平洋時間の11月16日23時59分、日本時間では11月17日16時59分だ。期限を過ぎると、Fableは使用量クレジットでの利用に戻ると、Anthropicのヘルプセンターに明記されている。
開発ツールの側はどうか。GitHub Copilotは9月にFable 5.1を提供済みだが、その経緯のとおり、新版の追加は別の告知で決まる。Cursorも同様だ。11月10日朝の時点で、両ツールでのFable 5.2の提供は、確認した範囲では見つからなかった。
💡 5.1から5.2へ切り替える前に
Fable 5.1を使っている場合、移行の価値は大きい部類です。単価が2割下がり、性能の自己申告値も上がっています。ただし、Anthropicは5.1の提供終了日を今回の発表で示していません。本番の処理を乗り換えるなら、同じ入力を20〜30件ほど新旧で流し、答えの質と使われたトークン量を並べてから切り替えると安全です。単価が下がっても、考えるために使うトークンの量が増えれば総額は下がらないので、見るべきは単価ではなく、1仕事あたりの請求です。
Section 05
編集部の見立て
Editor's Opinion
今回の発表で最も注目したのは、2割の値下げそのものではありません。Anthropic自身が「まずはOpus 5.5から」と案内している点です。最上位の新版を出した直後に、最上位を標準にしないよう薦める構図は、価格表の読み方を変えます。
Fableは「いつでも使う頭脳」から「ここぞで上がる階段の最上段」へ位置づけが移りました。選ぶ人の側から見れば、モデルの優劣を比べるより先に、自分の仕事を段に振り分ける作業が要ります。日常の大半はOpus 5.5やSonnet 5.5で足り、Fableが必要なのは長く自走させる大きな仕事だけ。この線引きができている人ほど、今回の値下げの恩恵を受けられます。
もう一つ気になったのは、FableとMythosが同じモデルだという点です。違いは能力ではなく、誰に何を許すかという入口の設計にあります。Fable 5.2は止める量を約55%減らしたと言いますが、これは自己申告です。サイバーや生物学の隣接領域で仕事をする人は、自分の用途がどこで止まるのかを、実際に試して確かめる必要があります。
そのうえで、数字はいずれも発表直後のものです。第三者の再現はこれから出てきます。新版が出るたびに単価と上限の条件が動いてきたこの数か月を踏まえると、いま決めた使い分けも、次の版で見直す前提で組むのが無理のない進め方だと考えています。
Section 06
まとめ
2026年11月9日、AnthropicはClaude Fable 5.2とClaude Mythos 5.2を発表しました。標準価格は入力8ドル・出力40ドルで、Fable 5.1の10ドル・50ドルから20%下がっています。キャッシュ読み取りは0.25ドルから0.20ドルへ。新しい高速モードは標準の2倍の料金で、出力が最大2.5倍の速さになります。
FableとMythosは同じモデルです。Fableは誰でも使えますが、危険度の高いサイバー作業と生物学の研究の大半は止まります。Mythosはその安全装置がなく、審査を通った組織だけが使えます。Fable 5.2が止める量は、5.1より全体で約55%少ないとAnthropicは説明しています。
性能はAnthropicの自己申告で大きく伸び、Artificial Analysisの一覧でもFable 5.2(max)が65点で首位です。ただし、Gemini 4 Carbonとの差は5点、Opus 5.5との差は6点にとどまり、AutomationBenchなどでは他社が上です。Anthropicの案内も、まずOpus 5.5から始めるよう薦めています。
選び方の軸は、「最も強いモデル」ではなく「どの仕事に2倍を払うか」です。Fable 5.2は、長く自走させる大きな仕事のために取っておくのが、価格表から読める素直な使い方になります。
次に確かめたいのは、第三者による再現と、CopilotやCursorなど開発ツール側での提供開始だ。Fable 5.2の値札が、ここで書いた使い分けのまま保たれるかどうかも、続報で見ていく。