Metaが11月9日、同社でもっとも小さく安いモデル「Muse Ember」を公開した。APIでのモデルIDは muse-ember-1.0。値札は入力100万トークンあたり0.10ドル、出力0.50ドルで、一度読ませた前置きを使い回すキャッシュ済み入力は0.004ドルである。
数字だけ見れば、また最安値が塗り替わったように読める。ところが隣に並べると別の絵が出てくる。Anthropicが出しているClaude Haiku 5.5も、ChatGPTと同じOpenAIが開発者向けに売っているGPT-6 Lunaも、標準の単価は入力0.10ドル・出力0.50ドルだ。いちばん安い段の値札は、3社ですでに同額に揃っている。
では何で分かれるのか。2つある。1つはその0.10ドルがどこまで有効かで、単価の段が上がるプロンプト長が3社で10万・20万・27.2万トークンと違う。もう1つは1つの仕事を仕上げるまでに何トークン書くかだ。第三者のArtificial Analysisの測定では、Muse EmberとHaiku 5.5は知能指数が同じ36点でありながら、1タスクあたりの費用が0.14ドルと0.41ドルに分かれた。Haiku 5.5の段については10月の記事で伝えた。ここでは、値札が揃ったあとの見分け方に絞る。
⚠ 情報の鮮度について
一次情報はMetaの公式発表(2026年11月9日)と、同日のVentureBeat・SiliconANGLEの報道です。この記事は発表から約1日後の時点で書いています。単価はいずれも開発者向けAPIの公表価格で、ChatGPTやClaudeの月額プランの価格ではありません。Muse Emberの単価はMetaの公式発表、Claude Haiku 5.5はAnthropic公式の料金ページ、GPT-6 LunaはOpenAI公式の料金ページで、2026年11月10日に確認しています。ベンチマークのうちArtificial Analysisの指数だけが第三者の測定で、残りはMeta自身の測定です。
Section 01
Muse Emberとは──何が出て、いくらなのか
Muse Emberは、Metaのモデル群「Muse」のいちばん下に置かれた小型モデルだ。Metaが想定用途として挙げているのは、道具の呼び出し、コードの小さな下請け作業、依頼の振り分け、文書からの抽出、長い資料の読み取り。つまり賢さを競う仕事ではなく、量をさばく仕事である。上位のMuse Wonder Fullで学習させた最初のモデルだとMetaは説明している。
使える場所は、Metaの開発者向けAPIであるMeta Model API、同社のコーディング環境Muse Code、それにOracle Cloudと、プレビュー扱いのGoogle Cloud。扱える入力は文章・画像・音声・動画・PDFで、返ってくるのは文章だ。文脈の上限はMetaの表記で1Mトークン、出力は最大512Kトークン。VentureBeatはこれをそれぞれ1,048,576トークン、524,288トークンと報じている。重みとパラメータ数は公開されていない。
| Muse Ember(100万トークンあたり) | プロンプト20万トークンまで | 20万トークンを超えたとき |
|---|---|---|
| 入力 | 0.10ドル | 0.30ドル |
| キャッシュ済みの入力 | 0.004ドル | 0.012ドル |
| 出力 | 0.50ドル | 1.50ドル |
一言でまとめると──「最安帯の値札そのものは、もう差になりません」。Muse Emberの0.10ドル・0.50ドルは、Claude Haiku 5.5とGPT-6 Lunaの標準単価と同額です。請求額を分けるのは、段が上がるトークン数と、1件仕上げるまでに書くトークン数の2つになりました。
Section 02
最安モデルの値札が、3社で同額に揃った
3社の最小モデルの標準単価を、同じ表に置いてみる。
| 100万トークンあたり(標準の段) | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| 入力 | 0.10ドル | 0.10ドル | 0.10ドル |
| 出力 | 0.50ドル | 0.50ドル | 0.50ドル |
| キャッシュ済みの入力 | 0.004ドル | 0.01ドル | 0.01ドル |
| 段が上がるプロンプト長 | 20万トークン | 10万トークン | 27.2万トークン |
入力と出力はぴたりと同じ。唯一ずれているのがキャッシュ済み入力で、Muse Emberの0.004ドルは他の2つの0.01ドルより安い。これは小さな差に見えて、同じ前置きを何度も送り直すエージェント型の使い方では請求の中身を左右する。第4章で出てくる1タスクの費用差にも、ここが一枚噛んでいる。
値札が横並びになったという事実自体が、この最安帯で何が起きているかを示している。替えが利く市場では、誰かが下げれば全員が追う。追い切ったところが床になる。0.10ドルと0.50ドルという数字は、いまのところその床として機能している。
ただし全社が同じ値札に乗っているわけではない。Geminiの現行世代でいちばん安いGemini 3.5 Flash-Liteは、Googleの料金ページで入力0.30ドル・出力2.50ドルだ。0.10ドル・0.50ドルの3倍と5倍にあたる。Googleの一覧には入力0.10ドル・出力0.40ドルという値札も残っているが、これは2.5世代のFlash-Liteで、現行のモデルではない。
代わりにGeminiのFlash-Lite系には、プロンプト長による段が無い。Googleが文脈長で単価を切り替えているのはPro系だけで、しきい値は20万トークンである。安い値札と、段が無いこと。どちらも請求書に出る要素なので、片方だけを見ても比較にはならない。
ⓘ トークンと単価の読み方
トークンはAIが文章を処理する単位で、日本語なら1文字が1〜2トークン前後に相当します。API料金はこの100万トークンあたりの金額で示されます。入力は読ませた分、出力は書かせた分で、ふつう出力のほうが数倍高く設定されます。キャッシュ済みの入力とは、同じ前置きを繰り返し送るときに割引で処理される分のことです。
Section 03
Muse Emberの料金──20万トークンで段が上がる
ここが、報道の見出しにはほぼ出てこない部分だ。3社とも単価は1つの数字ではなく、プロンプトの長さで段が切り替わる階段になっている。そして段の位置も、超えたときの倍率も、3社で違う。
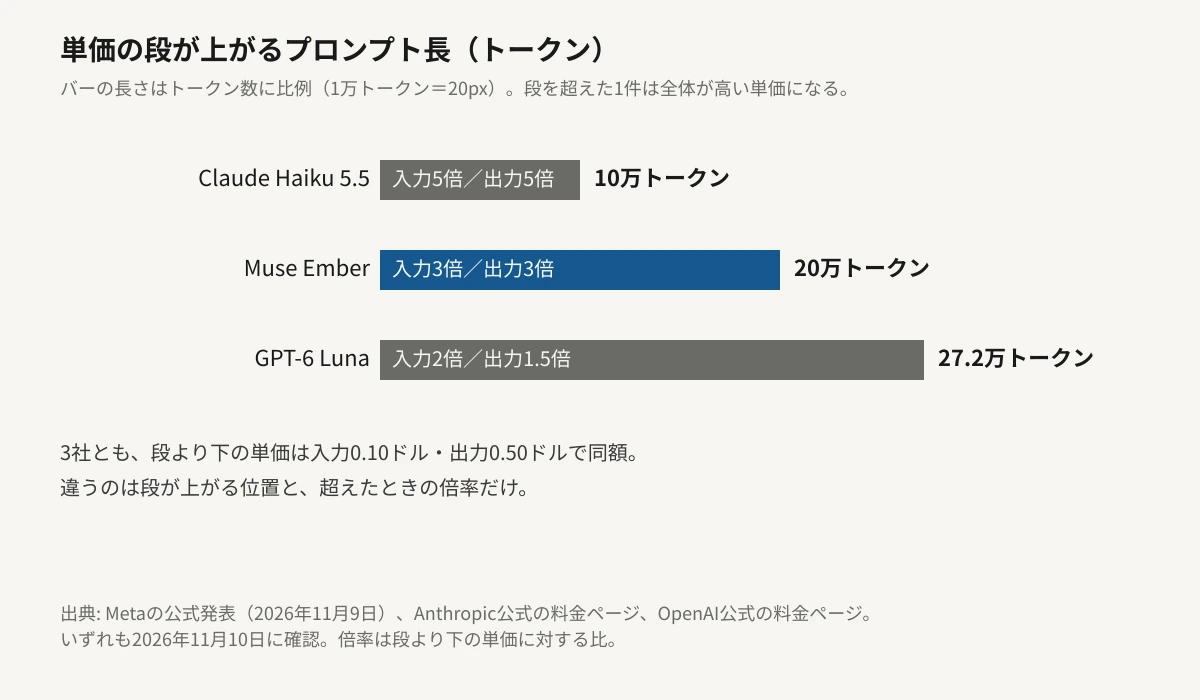
Muse Emberは20万トークンを超えると、入力が0.30ドル、出力が1.50ドルになる。どちらも3倍だ。Claude Haiku 5.5は10万トークンで入力0.50ドル・出力2.50ドルの5倍に跳ね、GPT-6 Lunaは27.2万トークンで入力0.20ドル・出力0.75ドル、つまり入力2倍・出力1.5倍にとどまる。いちばん早く段が来るのがHaiku 5.5で、いちばん上がり幅が小さいのがLunaである。
段の作りには、請求書に直接響く細かい決まりがある。はっきり書いてあるのはClaude Haiku 5.5のほうだ。Anthropic公式の料金ページは、プロンプト長をキャッシュの読み書きを含む入力トークン全部で測り、しきい値を超えたリクエストは一部がキャッシュに当たっていても高いほうの単価で課金されると明記している。値段はリクエストごとに個別に決まり、前のリクエストの単価は引きずらない。
Muse Emberのほうは、そこが書かれていない。Metaの公式発表にも開発者向けのモデルページにも、単価の表と「20万トークンまでの価格です」という注記しか無く、段の適用範囲の説明が無い。VentureBeatは、超えた単価はリクエスト全体に掛かって出力も高いほうで数えられる、キャッシュ済みの入力と previous_response_id で引き継いだ会話履歴も段の判定に数えられると書いているが、Metaが明示していない読み方なので※観測として扱う。長い入力を流す予定なら、最初の請求で実額を確かめるのが早い。
そのVentureBeatの読みに立つと、段差はこうなる。入力20万トークン・出力1万トークンのリクエストは約2.5セント。入力を1トークン足しただけで、同じリクエストが約7.5セントになる。3倍である。長い資料をまとめて読ませる使い方では、プロンプトが数%伸びただけで請求が跳ねる場所があるということだ。
⚠ 「1Mトークン対応」と「1Mトークンが同じ単価」は別の話
Muse Emberの文脈上限は1Mトークンありますが、標準単価が有効なのは20万トークンまでです。つまり上限の8割は高い段での利用になります。Claude Haiku 5.5も同じ構造で、Anthropicは4.6世代以降のモデルについて100万トークンの文脈すべてが標準価格だと説明したうえで、Haiku 5.5だけをその例外として挙げています。長い文脈を売りにしているモデルほど、段がどこにあるかを先に見てください。
Section 04
同じ36点でも請求は約2.9倍違った
もう1つの分かれ目は、単価の表には載っていない。同じ仕事を終わらせるまでに、そのモデルが何トークン書くかだ。
第三者のArtificial Analysisは、複数のベンチマークをまとめた知能指数とあわせて、その指数を走らせるのにかかった費用を出している。推論を最大にした設定で、Muse Emberは36点、Claude Haiku 5.5も36点。点数は同じだった。ところが1タスクあたりの費用は0.14ドルと0.41ドルで、約2.9倍の開きが出た。
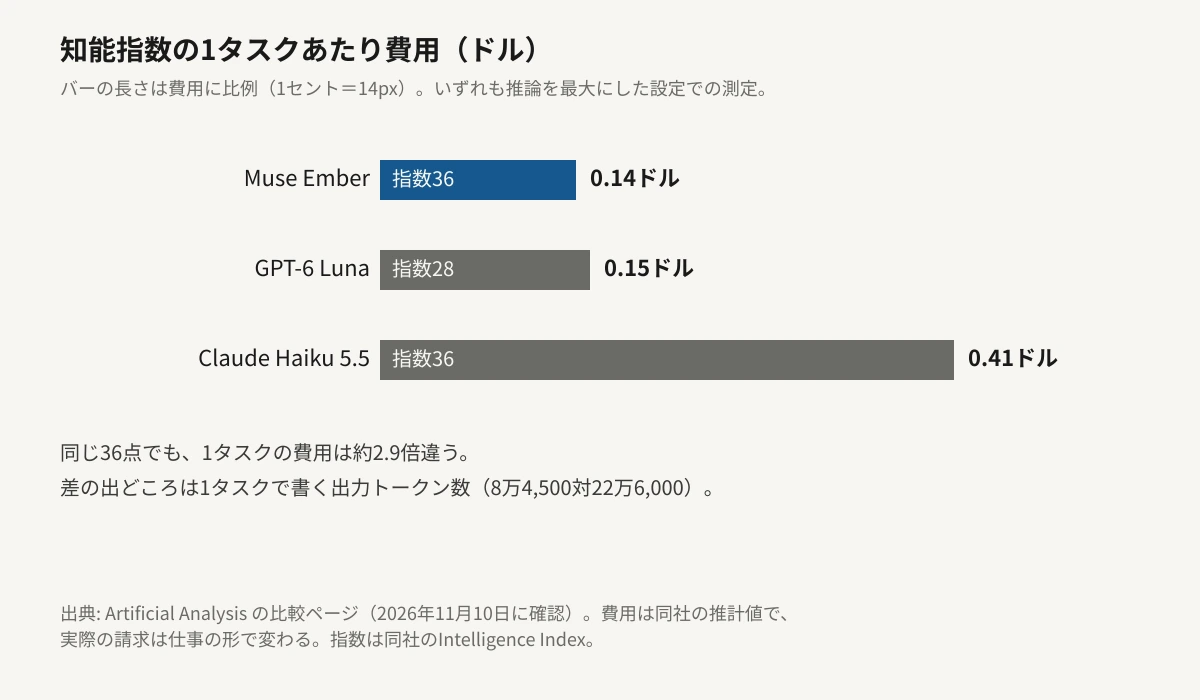
差の出どころは、同じ測定の別の欄に書いてある。1タスクあたりの出力トークン数が、Muse Emberは8万4,500、Claude Haiku 5.5は22万6,000。約2.7倍の開きがある。単価が同じなら、書く量がそのまま請求額になる。Artificial Analysisは、Muse Emberの安さの一部はキャッシュ読み取りの単価が安いことによるとも記している。
36点
Muse EmberとClaude Haiku 5.5の知能指数(同点)
約2.9倍
1タスクあたり費用の差(0.41ドル対0.14ドル)
約2.7倍
1タスクあたり出力トークン数の差
GPT-6 Lunaを同じ物差しに乗せると、また別の形になる。1タスクの費用は0.15ドルでMuse Emberの0.14ドルとほぼ同じ、出力トークン数も7万5,300でむしろ少ない。しかし知能指数は28点だ。Lunaに対してMuse Emberが主張しているのは安さではなく、ほぼ同じ費用で8点高いという点数差になる。
点数の読み方には留保が要る。VentureBeatによれば、Metaが示した図の小数まで出した値はMuse Ember 35.8、Claude Haiku 5.5 36.2で、丸める前はHaiku 5.5がわずかに上だった。36点の同点は、小数第1位を落とした結果である。
得意不得意もはっきり分かれている。Metaの測定では、業務アプリを操作させるAutomationBench-AAでMuse Emberが37.8%を全部やり切ったのに対し、GPT-6 Lunaは20.2%、Claude Haiku 5.5は13.9%。コーディング用の指標Coding Agent Indexでも46点対37点対31点でMuse Emberが上だ。一方でFrontierCode 2.0ではHaiku 5.5の34.9%に対しMuse Emberは27.2%で負けている。
同じベンチマークでも、採点の仕方で数字が変わる点は押さえておきたい。上のAutomationBench-AAの37.8%は全部やり切った課題の割合で、部分点を認めるArtificial Analysisの集計ではMuse Emberは68.1%になる。同じ測定が37.8%とも68.1%とも読める。パソコン操作のOSWorld 2.1も同じで、部分点ありなら69.5%、全手順の成功だけを数えると33.8%まで落ちる(Claude Haiku 5.5は27.8%、GPT-6 Lunaは17.0%)。手順を1つも落とせない仕事に回すなら、見るべきは後者の数字である。
Section 05
で、選ぶ側は何を確かめるか
最安帯の単価が横並びになった以上、料金ページの先頭の数字を見比べても判断材料にならない。確かめる場所は3つに移る。
01
自分のプロンプトが何トークンか測る
段の位置が10万・20万・27.2万トークンと違うので、同じ仕事でも使うモデルによって段の内側か外側かが変わる。社内文書やコードをまとめて渡す使い方は、10万トークンを超えやすい。測るのは平均ではなく、いちばん長いリクエストのほうだ。
02
段をまたぐ回数を数える
しきい値の判定に数えられるのは入力トークン全部で、キャッシュに当たった分も含まれる。Claude Haiku 5.5はAnthropicが公式に明記しており、Muse Emberは※観測の扱いだ。往復を重ねるエージェント型の使い方では、後半のリクエストから段の外に出ていることがある。どの割合で段を越えているかを記録しておく。
03
トークン単価ではなく1件あたりで比べる
同じ0.10ドル・0.50ドルでも、1タスクの費用は0.14ドルと0.41ドルに分かれた。自分の仕事で同じ入力を20〜30件流し、出力トークン数・やり直しの回数・上位モデルへ送り直した件数まで足して1件あたりを出す。これが実際の請求に近い。
💡 置き換えるなら、まずここから
Muse Emberが強く出たAutomationBench-AAは、業務アプリを操作する657個の課題です。道具の呼び出し、抽出、振り分け、テストの実行のように合否がその場で判定できる仕事は移しやすい部類に入ります。逆に、長く自走させる設計判断や、画面を操作しきる必要がある作業は、OSWorld 2.1の全手順成功が33.8%という数字のほうを基準に考えてください。
月額プランを使っているだけの読者には、今回の変更は請求書に出ない。動いたのは開発者向けAPIの価格表で、ChatGPTやClaudeの月額プランは関係しない。ただし、GitHub CopilotやCursorのように上流のモデルを仕入れて売る道具では、仕入れ値の構造がいずれ提供内容に反映される。最安帯の性能が上がれば、無料枠や下位プランで回せる作業の幅が広がる方向に働く。
Section 06
編集部の見立て
Editor's Opinion
今回いちばん重いのは、Muse Emberが安いことではないと考えます。3社の最安モデルが、入力0.10ドル・出力0.50ドルという同じ値札で並んだという事実のほうです。これまで「安いAIを探す」は料金ページの数字を見比べる作業でした。その数字が揃ってしまったので、見比べる対象を変えなければなりません。
代わりに前に出てきたのが、段の位置と1件あたりの費用です。どちらも料金ページの見出しには載っていません。段は注記の中にあり、1件あたりの費用は第三者の測定か、自分で測るしかありません。値札が同じになった分、読者の手間は増えたというのが率直なところです。
Metaの「3分の1の費用」という言い方にも、少し注意が必要だと考えます。これは単価が3分の1なのではなく、同じ課題を終えるまでに書くトークンが少なかったという意味です。ということは、仕事の形が変われば比率も変わります。長い文書を読ませて短く答えさせる仕事なら、差は縮むはずです。3分の1は性質ではなく、ある測定での結果だと受け取るのが妥当でしょう。
そして20万トークンという段の位置は、1Mトークンの文脈という売り文句と並べると、やや不均衡に見えます。Claude Haiku 5.5の10万トークンも同じ構えで、Anthropicは自社の他のモデルでは100万トークン全域が標準価格だと書いたうえで、Haiku 5.5だけを例外にしています。一方でGeminiのFlash-Lite系は段を置いていません。最安帯で長い文脈を安く売るとき、段を置くかどうかで判断が分かれているところです。この形が標準になるのか、それとも次の値下げ競争で段の位置が押し下げられるのかは、まだ分かりません。
Section 07
まとめ
2026年11月9日、MetaがMuse Emberを公開しました。標準単価は100万トークンあたり入力0.10ドル・出力0.50ドル、キャッシュ済みの入力0.004ドル。文脈の上限はMetaの表記で1Mトークン、出力は最大512Kトークンです。
この入力0.10ドル・出力0.50ドルは、Claude Haiku 5.5とGPT-6 Lunaの標準単価と同額です。違うのは段が上がるプロンプト長で、Claude Haiku 5.5が10万トークン(超えると5倍)、Muse Emberが20万トークン(3倍)、GPT-6 Lunaが27.2万トークン(入力2倍・出力1.5倍)。Claude Haiku 5.5については、しきい値を超えたリクエストが全体として高い単価になることをAnthropicが明記しています。Muse Emberの適用範囲はMetaが示しておらず、VentureBeatの読みを※観測として載せました。
第三者のArtificial Analysisの測定では、Muse EmberとClaude Haiku 5.5が知能指数36点で同点、1タスクあたり費用は0.14ドルと0.41ドルで約2.9倍の開きでした。出どころは1タスクの出力トークン数で、8万4,500対22万6,000の約2.7倍です。ただしMetaの図の小数まで見るとMuse Ember 35.8、Haiku 5.5 36.2で、丸める前はHaiku 5.5がわずかに上でした。
得意不得意は分かれています。業務アプリ操作のAutomationBench-AAはMuse Emberが37.8%で、GPT-6 Luna 20.2%・Claude Haiku 5.5 13.9%を上回りました。ただしこの37.8%は全部やり切った割合で、部分点を認めるArtificial Analysisの集計では68.1%になります。一方FrontierCode 2.0ではHaiku 5.5の34.9%に対しMuse Emberは27.2%。OSWorld 2.1は全手順成功で数えると33.8%まで落ちます。動いたのは開発者向けAPIの価格表だけで、ChatGPTやClaudeの月額プランは変わっていません。
いちばん安い段の値札は、3社とも入力0.10ドル・出力0.50ドルで止まった。次に動くのは値札ではなく、段が上がるトークン数のほうかもしれない。10万トークンと27.2万トークンの間には、まだ2.7倍の開きが残っている。