AlibabaのQwen4-Maxに、ようやく値札が付いた。11月11日に定額プラン専用のプレビューとして出たモデルが、5日後に正式版「qwen4-max」として従量課金のAPIに載り、Alibaba Cloud Model Studioの料金ページには100万トークンあたり入力1.50ドル・出力4.50ドル(シンガポール)の行が加わった。
前世代のQwen3.8-Max(入力2.00ドル・出力6.00ドル)からは、入力・出力とも25%下がっている。Claude の最上位Opus 5.5の出力20.00ドルと比べれば、4分の1以下の値段になる。
ただし、プレビューで試していた人がそのまま乗り換えると、つまずく点がある。推論の強さの既定値と、出力の上限が変わっている。単価の読み方とあわせて、どこが変わったのかを整理する。
⚠ 情報の鮮度について
一次情報はAlibaba Cloud Model Studioの公式ドキュメント(qwen4-maxのモデルページ、料金ページ、プレビュー版のページ。いずれも2026年11月16日更新)です。英語圏ではUnite.aiが11月15日付(米国時間)で正式版の公開を報じており、そこからおよそ2日が経っています。料金は11月16日時点の公表値で、ClaudeのAPI価格はAnthropic公式の料金ページの値です。申し込む前に最新の公式ページをご確認ください。
Section 01
Qwen4-Maxとは──5日前のプレビューと何が違うか
QwenはAlibabaが開発する大規模言語モデルのシリーズで、「Max」はその最上位を指す。11月11日に始まったプレビュー版(プレビュー公開時の記事で詳しく扱った)は、単価もベンチマークも公表されず、月額の定額プラン「Token Plan」の中でしか呼べなかった。今回の正式版で、その空白の多くが埋まった。
公式ドキュメントのプレビュー版のページには、11月16日付で「正式版のQwen4-Maxが利用可能で、こちらの利用を推奨する」という一文が加わった。プレビュー版は予定どおり11月25日24時(中国時間、日本時間では26日午前1時)で提供を終える。
| 項目 | プレビュー版(11/11〜) | 正式版(11/16時点) |
|---|---|---|
| モデルID | qwen4-max-preview | qwen4-max |
| 従量課金のAPI | 非対応(Token Planのみ) | 対応 |
| 推論の強さ(reasoning_effort) | low・medium・xhigh(既定はxhigh) | low・high・xhigh(既定はhigh) |
| 思考と回答を合わせた出力の上限 | 39万3,216トークン | 26万2,144トークン |
| 文脈の長さ | 100万トークン | 100万トークン |
| 提供期間 | 11月25日24時(中国時間)まで | 期限の記載なし |
推論の強さとは、回答の前にモデルが内部でどれだけ考えるかの設定で、強いほど時間とトークンを使う。プレビュー版は何も指定しなければ最大のxhighで動いたが、正式版の既定は一段下のhighになり、選択肢からmediumが消えた。プレビュー用に reasoning_effort: "medium" と書いた設定は、正式版ではそのまま通らない可能性があるので、モデルIDと一緒に見直したい。
5日
プレビュー開始(11/11)から正式版まで
25%
前世代Qwen3.8-Maxからの値下げ幅
100万
文脈の長さ(トークン)
一言でまとめると──「試供品だった新しい旗艦が、5日で普通に買える商品になった」発表です。値段は前世代から25%下がり、Claudeの上位モデルと比べると出力は数分の1になりました。
Section 02
Qwen4-Maxの料金──地域で単価が2つある
料金ページを開くと、qwen4-maxの単価は1つではない。どの地域(リージョン)で呼ぶかによって2通りの値段が並んでいる。
| リージョン(100万トークンあたり) | 入力 | 出力 | キャッシュ読み出し |
|---|---|---|---|
| シンガポール | 1.50ドル | 4.50ドル | 0.075ドル |
| 東京・バージニア・フランクフルト・香港 | 1.413ドル | 4.24ドル | 0.071ドル |
| 北京(中国本土向け) | 1.413ドル | 4.24ドル | 0.071ドル |
見出しの数字として報じられているのはシンガポールの1.50ドル・4.50ドルだが、東京リージョンで呼ぶと入力1.413ドル・出力4.24ドルで、約6%安い。そのかわり、シンガポールにだけ新規向けの無料枠(100万トークン、有効期間90日)が付く。
課金の階層もいくつか確かめておく。
- 文脈の長さによる割増は無い。料金ページの区分は「0〜100万トークン」の1段だけで、長い資料を読ませても単価は変わらない。
- 思考モードのオン・オフで単価は同じ。ただし推論を強くするほど使うトークンが増えるので、請求額はそのぶん増える。
- キャッシュは入力だけが安くなる。同じ前置き(社内規程やリポジトリの説明など)を繰り返し送る使い方では、読み出しが入力の5%の値段になる。書き込みは5分保持で1.875ドル、1時間保持で3.00ドル(シンガポール)と、通常の入力より高い。
- バッチ処理には対応していない。モデルページの機能表は、全リージョンで「非対応」としている。
前世代のQwen3.8-Maxは、シンガポールで入力2.00ドル・出力6.00ドルだった(8月のQwen3.8-Maxの記事)。今回の1.50ドル・4.50ドルは、どちらもちょうど25%の引き下げにあたる。
Section 03
Claudeと並べると、出力は4分の1以下になる
コーディングやエージェントの用途で比べられやすいのは、AnthropicのClaudeだ。Anthropic公式の料金ページでは、最上位のOpus 5.5が入力4.00ドル・出力20.00ドル、中位のSonnet 5.5が入力2.00ドル・出力10.00ドルになっている。
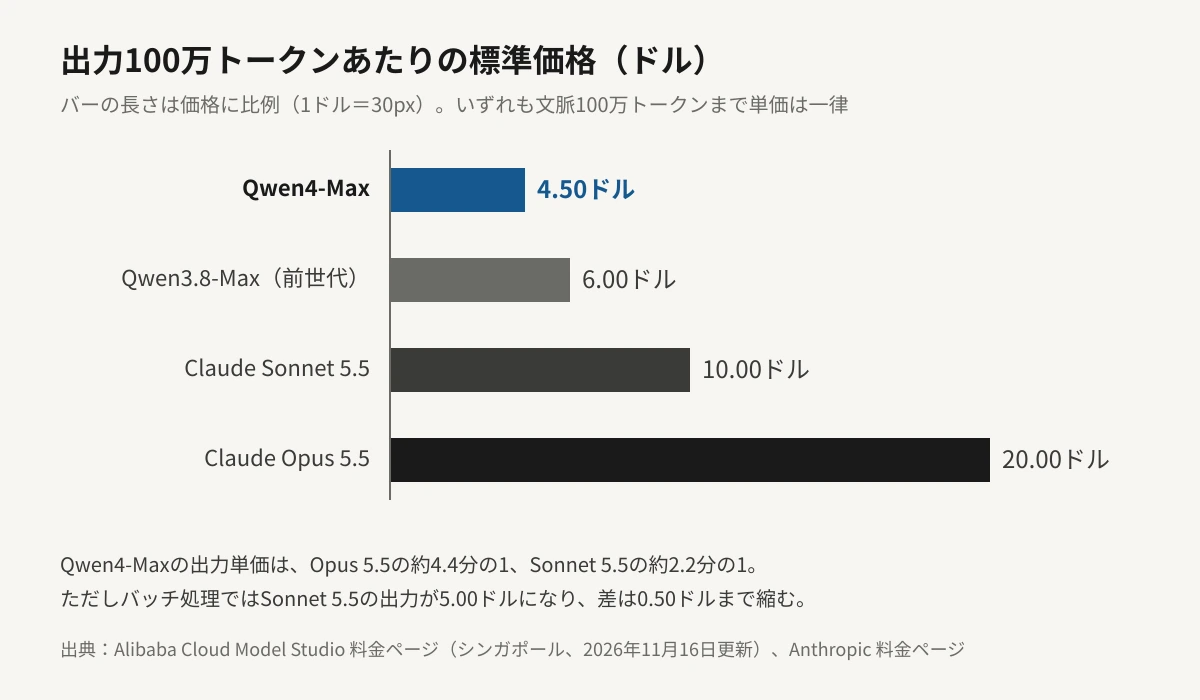
出力で比べると、Qwen4-Maxの4.50ドルはOpus 5.5の20.00ドルの約4.4分の1、Sonnet 5.5の10.00ドルの約2.2分の1になる。入力ではOpus 5.5の4.00ドルに対して約2.7分の1だが、Sonnet 5.5の2.00ドルとの差は0.50ドルしかない。
比べるときの条件は、両社でそろっている部分とそろっていない部分がある。
01
文脈の長さ:両社とも割増なし
Qwen4-Maxは100万トークンまで1段の単価。AnthropicもOpus 5.5とSonnet 5.5は100万トークンの文脈全体を標準価格としている。長い入力で順位が入れ替わることはない。
02
バッチ:Claudeだけが半額
AnthropicのバッチAPIは入力・出力とも50%引きで、Sonnet 5.5なら入力1.00ドル・出力5.00ドルになる。Qwen4-Maxはバッチに対応していないので、急がない一括処理では出力の差が0.50ドルまで縮み、入力はSonnet 5.5のほうが安くなる。
03
キャッシュ:どちらも入力の5%
Qwen4-Maxの読み出しは0.075ドル、Opus 5.5は0.20ドル、Sonnet 5.5は0.10ドル。いずれも基本の入力単価の5%で、倍率は同じだ。
ⓘ 単価が安くても、1回の作業が安いとは限りません
APIの請求額は「単価×使ったトークン数」で決まります。同じ課題を解くのに必要なトークン数はモデルごとに違い、推論の強さを上げればさらに増えます。比べるときは、100万トークンあたりの値段ではなく、手元の課題を1件こなすのにかかった金額で並べるのが確実です。
Section 04
性能の数字は、ほぼすべて自社の計測
プレビューのときには1つも無かった性能の数字も、正式版では出てきた。ただし、その大半はAlibaba自身が測ったものだ。
Alibabaの公式ブログを引いた各メディアの報道によれば、Qwen4-Maxの総パラメータは2.4兆で、1トークンの処理で実際に動くのはそのうち710億(71B)だけという混合エキスパート(MoE)型の設計になっている。総パラメータの数は前世代と同じで、変わったのは中身の作りだという(※観測)。
Alibabaが前面に出しているのは、自社で作った業務タスクの評価「Work360」の結果だ。
- 同じ課題に使うトークンは、推論の強さxhighで約24%、highで約35%減った。
- その結果、1タスクあたりの平均費用は4.43ドルから1.67ドルへ、62%下がったという。
いずれも同社の公式ブログの数字として複数の英語メディアが伝えている内容で、外部の検証は付いていない(※観測)。
この62%は、単価の25%引きとトークン数の削減が組み合わさった結果で、比べている相手は自社の前世代だけだ。他社のモデルと同じ条件で並べた第三者の結果は、まだ揃っていない。安全面でも、攻撃能力を高めるデータを学習から外したこと、安全なコードを書けた割合を測る評価が22%から31.8%に上がったことを挙げていると報じられているが、こちらも自社の評価である(※観測)。
重みは公開されていない。Alibabaは、より小さいQwen4のモデルを今後オープンソースで出すとしているが、時期や大きさは示していない。
💡 自分で測るなら、この順番で
いつも使っているモデルとQwen4-Maxに、手元の課題を10〜20件ずつ同じ道具(同じエディタやエージェント)から流し、成否・使ったトークン数・かかった金額を並べてください。推論の強さをhighとxhighの両方で試しておくと、どこまで上げれば元が取れるかも分かります。
Section 05
東京から呼ぶ前に確かめる3つのこと
日本から使うなら、東京リージョンが単価の面でも距離の面でも候補に上がる。そのうえで、契約の前に見ておきたい点が3つある。
- 推論がどこで走るか qwen4-maxの東京リージョンの料金は「Global」という区分で載っている。Alibaba Cloudの説明では、保存されるデータは選んだリージョンに留まる一方、推論を実行する場所は区分で決まる。Globalは、地域の規制上の要件が無い場合に、より大きな計算資源の中から推論を割り当てるための区分と説明されている。社内の規程で処理の場所まで決まっている場合は、この点を先に確認したい。
- プレビュー用の設定を直したか モデルIDをqwen4-maxに替え、
reasoning_effortにmediumを書いていないかを見る。出力の上限を思考込みで39万トークン前後に置いていた場合は、正式版の26万2,144トークンに収まるよう下げておく。 - Token Planで使うか、従量課金で使うか 正式版のqwen4-maxはToken Plan(個人向け)の対象モデルにも入った。ただしToken Planの規約は、使ってよいのをコーディングツールやエージェントツールでの対話的な利用に限り、自動化スクリプトや自社サービスの裏側、一括処理には使えないとしている。人が画面の前にいない使い方なら、従量課金のAPIを選ぶことになる。
⚠ プレビュー版は11月26日午前1時(日本時間)に止まります
プレビュー版のqwen4-max-previewは、11月25日24時(中国時間)の期間終了後に提供を終えると公式に書かれています。プレビューのモデルIDを指定したままの設定やスクリプトは、その時点から呼び出しに失敗します。正式版への切り替えは、期限の前に済ませておくのが安全です。
Section 06
編集部の見立て
Editor's Opinion
プレビューの時点では、単価が無いために他社と同じ物差しで比べられないことが最大の空白でした。5日後に出てきた答えは、入力1.50ドル・出力4.50ドルという、前世代からちょうど25%下げた値段でした。最上位のモデルを、出力100万トークンあたり5ドルを切る値段で売るという判断は、Claudeの上位モデルと正面から価格で競うつもりがあることを示しています。
ただ、今回の数字で読者がいちばん注意すべきなのは、安さそのものよりも比べ方だと考えます。出力だけを見ればOpus 5.5の4分の1以下ですが、バッチで流せばSonnet 5.5との差は0.50ドルまで縮み、入力はむしろSonnet 5.5のほうが安くなります。夜間にまとめて流す処理と、エディタの中で対話しながら書かせる作業とでは、どちらが安いかが入れ替わりうるわけです。
もう一つ気になるのは、性能の裏付けがほぼ自社の評価に限られている点です。1タスクの費用が62%下がったという数字は、自社の評価で、自社の前世代と比べたものです。他社のモデルより安く仕事が終わるかどうかは、まだ誰も同じ条件で確かめていません。値札が出そろった今、残っている空白はそこだと見ています。
Section 07
まとめ
Alibabaは11月11日のプレビューから5日後、Qwen4-Maxの正式版をAlibaba Cloud Model Studioの従量課金APIで公開しました。単価は100万トークンあたり入力1.50ドル・出力4.50ドル(シンガポール)で、東京などのリージョンでは入力1.413ドル・出力4.24ドルです。前世代のQwen3.8-Maxから25%の引き下げになります。
Claude Opus 5.5(入力4.00ドル・出力20.00ドル)と比べると、出力は約4.4分の1です。ただしQwen4-Maxはバッチ処理に対応しておらず、バッチで流すClaude Sonnet 5.5(出力5.00ドル)との差は0.50ドルまで縮みます。
性能の数字は、1タスクあたりの費用が62%下がったという自社評価が中心で、第三者による比較はまだ揃っていません。正式版では推論の強さの既定がhighに、思考込みの出力上限が26万2,144トークンに変わりました。
プレビュー版のqwen4-max-previewは、日本時間11月26日午前1時に呼べなくなる。それまでに書き換える文字列は、モデルIDの末尾の「-preview」と、推論の強さの「medium」の2か所だ。