どのAIが強いかを知りたいとき、いちばん当てにならないのは「強い」と言っている側の発表で、いちばん当てになるのは、全社に毎月お金を払っている誰かの請求書である。
スライド生成サービスのGammaが11月16日、その請求書を公開した。月次レポート「Gamma Model Index」の11月版で、同社のAIエージェントがどの仕事をどのモデルに任せ、支出がどこへ流れたかを、割合まで添えて並べている。見出しはこうだ。10月の最終完全週、Gammaが払ったAI費用のうちOpenAIが40%、Anthropicが38%、Googleが9%。2023年以来はじめて、OpenAIがClaudeの提供元を上回った。
ただしこの数字は、順位表としてはほとんど意味がない。面白いのは内訳のほうだ。同じエージェントの中で、計画はAnthropic、修復と画像はOpenAI、執筆は三社が取り合うという形に割れている。しかも呼び出し回数で数え直すと、支出の順位はそのまま裏返る。
⚠ 情報の鮮度について
一次情報はGamma Researchの公式レポート(2026年11月16日公開・筆者はGamma共同創業者のJon Noronha/ジョン・ノロンハ氏)です。本記事公開時点で約9時間が経過しています。原文は編集部で確認しています。以下の数値はすべてGammaが自社のエージェントを計測したもので、第三者による独立したベンチマークではありません。支出は各社の定価での集計で、割引後の実際の支払額ではないとGammaは明記しています。
Section 01
Gamma Model Indexとは──毎週7,000万回モデルを呼ぶ会社が、請求書の中身を公開した
Gammaはプレゼン資料(デッキ)をAIに作らせるサービスで、Gamma Model Indexはその舞台裏を月1回公開するレポートだ。10月に本格投入された新しいエージェントが、どのモデルを採用し、どれを落としたかを、A/Bテストの結果とともに書いている。
規模の感覚をつかむために1つだけ数字を挙げると、10月27日から11月2日の1週間で、このエージェントは7,000万回を超えるモデル呼び出しを行い、2,000億トークンを超える量を処理している。トークンとは、AIが文章を処理するときの単位のことで、日本語なら1文字が1〜2トークン前後に相当する。
この規模が意味を持つのは、Gammaが1本のデッキを約12種類の「仕事」に分解しているからだ。ユーザーと会話して構成を決める仕事、構成を実際のスライドに書き起こす仕事、出来上がったスライドを画像として見て不具合を直す仕事──それぞれに別のモデルを割り当て、新しいモデルが出るたびに入れ替えを試す。だから1社の請求書でありながら、12通りの比較表になっている。
一言でまとめると──「AIの優劣は会社では決まらず、仕事ごとに決まる」。同じ1つの製品の中で、計画はAnthropic、画像とスライド修復はOpenAI、執筆は三社の取り合いという形に分かれていました。
ⓘ なぜスライドが観測地点になるのか
Gammaはレポートの中で、コーディング用のエージェントは「モデルがソフトを書く力」しか測れず、ベンチマークは「数学の力」しか測れないが、デッキを1本作る作業には調査・文章・構成・データ・デザインが全部入っている、と説明しています。利用者は経営層から教員、フリーランスから大企業までで、言語も数十に及ぶといいます。ふつうの人がする仕事でどのモデルが勝っているかを知るには、スライドが見やすい指標だという立場です。
Section 02
10月29日に何が入れ替わったのか
逆転が起きた日付は特定できる。10月29日、Gammaは3本のA/Bテストを同時に締め、その結果としてGPT-6.1 TerraがClaude Haiku 5.5とClaude Sonnet 5.5から複数の主要な仕事を奪った。GPT-6.1 Terraは10月26日に出たChatGPTの提供元の新型で、直前の大型モデルの半分ほどの費用で動く点が特徴になっている(登場時の記事はこちら)。
効果がいちばんはっきり出たのは、スライドの修復だった。Gammaのエージェントは書いたスライドを1枚ずつ画像として描画して検査し、検査に落ちたものはスクリーンショット付きで差し戻して直させる。この工程で、修復したあとも検査に落ち続けるスライドの割合が9.1%から4.7%へ半減したという。同じ週にテンプレート選びの仕事も移り、こちらは従来のモデルの2倍の速さ・半分の費用になったと書かれている。
40%
OpenAIの支出シェア(10月最終完全週)
38%
Anthropicの支出シェア(同)
9%
Googleの支出シェア(同)
Anthropic側が負けたわけではない点も押さえておきたい。Claude Sonnet 5.5は9月末の登場時、Gammaが抱える最も高額な仕事──ユーザーと会話してデッキの構成を決める「オーケストレーター」──を取り、それ以降すべての挑戦者を退けてきた。Claude Haiku 5.5は10月7日に登場し、依頼ベースの編集を引き受けて1回の編集あたりの費用を59%から89%下げた。品質は、ユーザーが提案をそのまま採用した割合で測って同等だったという。
要するに、1つのモデルが全部を取る形にはなっていない。Gammaの言い方を借りれば、各研究所は「仕事」を取り合っている。
Section 03
仕事別の内訳──計画はClaude、修復と画像はOpenAI、執筆は三つ巴
支出を仕事ごとに割ると、どこが誰のものかがはっきりする。
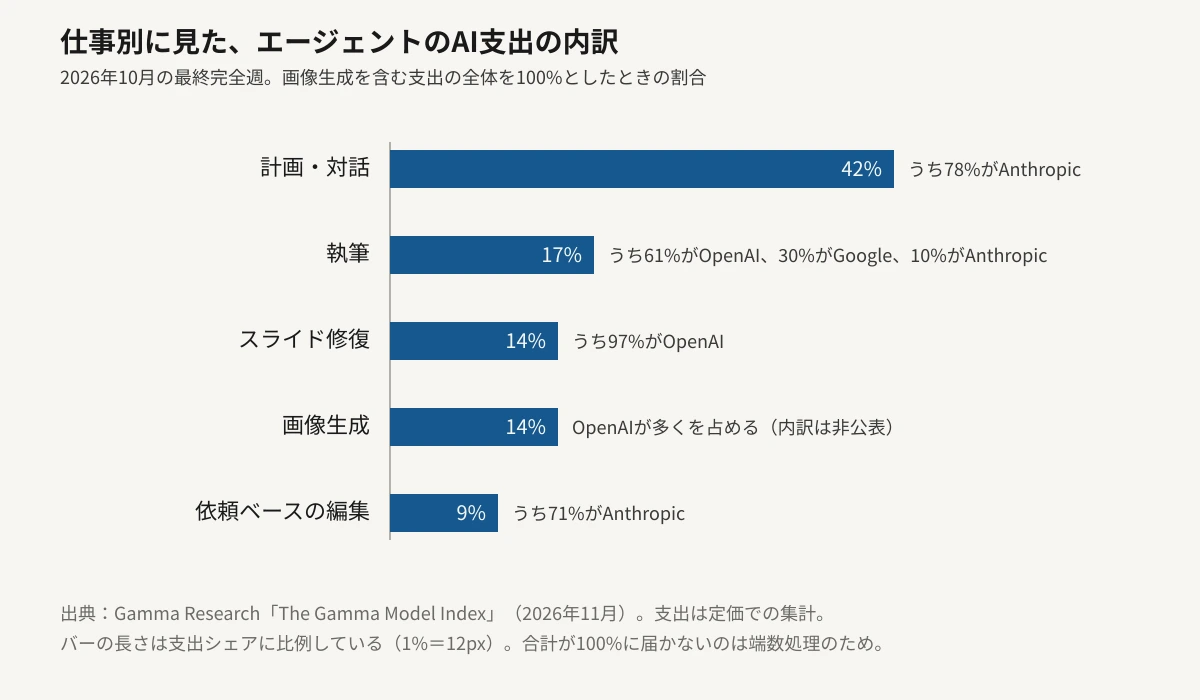
最大の費目は計画と対話で、支出全体の約42%。そのうち78%がAnthropicに流れている。依頼ベースの編集がさらに9%あり、こちらも71%がAnthropicだ。Gammaはこの2つを「人が何を意図しているかについて、最も判断を要する仕事」と位置づけ、OpenAIのモデルはここで苦戦し続けていると書いている。
Claude consistently wins at "do what I mean, not what I say".
(訳:「言われたとおりではなく、意図したとおりにやる」という点で、Claudeが一貫して勝つ。)
— Gamma Research「The Gamma Model Index: OpenAI takes the lead for the first time」(2026年11月)より
逆方向もはっきりしている。スライド修復は支出の14%で、その97%がOpenAI。画像生成がもう14%あり、こちらもOpenAIが多くを占める。見る仕事と描く仕事が、片側にほぼ全部寄っている。
残る執筆は17%で、ここだけOpenAI 61%、Google 30%、Anthropic 10%と三方向に割れた。新しいモデルが出たときに最も速くお金が動くのもここだとGammaは書いている。Geminiの3.8 Flashは無料プランのデッキ執筆を取った一方、スライドから文字がはみ出す頻度はGPT-6.1 Solの約2倍だったという注記も付いている。
| 仕事 | 支出シェア | 主に使われている提供元 |
|---|---|---|
| 計画・対話(オーケストレーター) | 約42% | Anthropic 78% |
| 執筆 | 17% | OpenAI 61% / Google 30% / Anthropic 10% |
| スライド修復 | 14% | OpenAI 97% |
| 画像生成 | 14% | OpenAIが多く(内訳は非公表) |
| 依頼ベースの編集 | 9% | Anthropic 71% |
Section 04
呼び出し回数で数えると、順位がそのまま裏返る
ここまでの数字はすべて金額である。同じ週を呼び出し回数で数えると、絵が反転する。
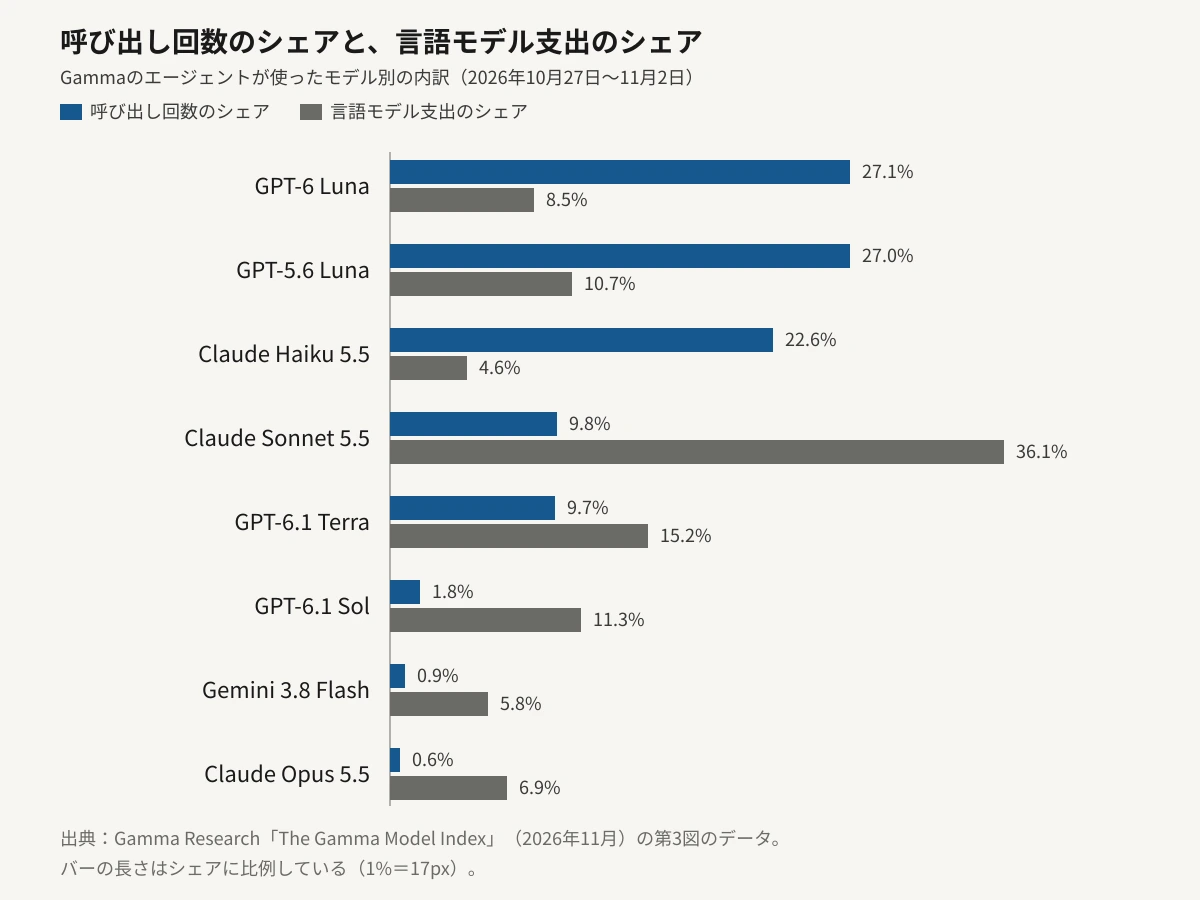
呼び出し回数の半分以上を占めるのは、OpenAIの小型モデル2本(GPT-6 LunaとGPT-5.6 Luna)で、合わせて54.1%。Claude Haiku 5.5がさらに22.6%を担う。この3本で全体の仕事の4分の3あまりをこなしているが、言語モデル支出では合計2割台にとどまる。
対になるのがClaude Sonnet 5.5だ。呼び出し回数では10回に1回(9.8%)でしかないのに、言語モデル支出の36.1%を持っていく。高い判断力を要する会話を一手に引き受けているからで、1回あたりの単価がそれだけ違う。
Gammaはこの構造から、小型モデルの競争がいちばん激しいと書いている。高頻度の仕事を1つ取れば、翌日から1日数百万回の呼び出しが流れ込むからだ。関連して、新しいほうが必ず良いとは限らないという観察も添えられている。GPT-6 LunaはGPT-5.6 Lunaよりトークンあたりの単価が安いのに、無料プランのデッキの計画はいまも古いGPT-5.6 Lunaが担当している。完走率が高く、速かったからだという。
出力の長さについての指摘も目を引く。横並びで測った2つの仕事で、OpenAIのモデルはClaudeのモデルより出力トークンが2.6〜4.6倍少なかった。同じ仕事を終えるのに書く量が少なければ、単価が同じでも請求額は下がる。単価表だけを見比べていては出てこない差である。
Section 05
ChatGPTとClaudeの違いは、どの仕事で出るのか
ここからは、この請求書を自分の使い方に置き換える話をする。まず前提を2つ外しておきたい。
⚠ これはAPIの話で、月額プランの話ではない
Gammaが払っているのは開発者向けAPIの料金で、ChatGPTやClaudeの個人向け月額プランとは別の値付けです。ここでの「OpenAIが40%」は、個人の使い勝手でOpenAIが勝ったという意味ではありません。もう1つ、支出は各社の定価で集計されていて、大口の割引は反映されていません。順位ではなく、どの仕事がどこへ寄ったかという形だけを読み取るのが安全です。
そのうえで、10月だけで20回を超えるA/Bテストの結果として残っている傾向は、使う側にそのまま置き換えられる。
01
言われていないことを拾ってほしい仕事はClaude
要件が複数あり、しかも全部書き出していない依頼──企画の相談、長い打ち合わせの整理、条件の多い文書の下書き。Gammaは最も判断を要する2つの仕事で、支出の7割超をAnthropicに置いている。
02
画面を見せて直させる仕事はOpenAI
スクリーンショットを渡して「ここが崩れている」と直させる類の作業。修復の支出97%がOpenAIに寄り、不合格スライドの残存率も9.1%から4.7%へ下がっている。画像生成も同じ側にある。
03
量をさばく仕事は、小型モデルで足りる
分類・整形・定型の下書きのように、同じ処理を大量に回す作業。Gammaでは小型3本が仕事の4分の3をこなし、支出は2割台だった。ここを上位モデルで回していると、請求額だけが膨らむ。
法人全体の傾向とは必ずしも一致しない点も押さえておきたい。Menlo Venturesが11月3日に出した法人調査では、開発者向けAPIの支出シェアはAnthropicが55%、Googleが9%で、OpenAIは31%だった(詳しくはこの記事)。Rampの集計でもAnthropicが優勢という結果が出ている(こちらの記事)。Gamma Model Indexは市場全体ではなく、1社が自分の約12種類の仕事に対して払った額である。だから順位より内訳を読む価値がある。
💡 自分の使い方を「仕事」に割ってみる
Gammaの数字がそのまま参考になるのは、割合ではなく分け方のほうです。いまAIに頼んでいることを、意図を読み取らせる仕事・画面を見せて直させる仕事・大量に回す仕事の3つに仕分けてみてください。1つのサービスで全部を済ませている場合、どこかの仕事で明らかに向いていないモデルを使っている可能性があります。仕分けができていれば、次に新しいモデルが出たときに、試す場所をすぐ決められます。
検証の時点にも注意が要る。Anthropicが11月9日に出したClaude Fable 5.2は、レポート公開時点でまだ大規模なテストに掛けられていない。Googleの新型についても、Gemini 4 Argonは最初の試験で呼び出しの一部が時間切れになり、Gemini 4 Hydrogenは有望な結果が出始めた段階だと書かれている。この内訳は11月16日時点のもので、12月には違う形になっていると考えるのが妥当だろう。
Section 06
編集部の見立て
Editor's Opinion
このレポートでいちばん価値があるのは、40%対38%という数字ではないと考えます。1社の請求書の内訳なので、順位としては何も決めていません。価値があるのは、「どのAIが強いか」という問いが、そもそも答えの出ない形をしていると示したところです。同じ会社の同じ製品の中で、計画はAnthropic、修復はOpenAIと分かれ、どちらも理由まで添えられています。
読者の多くはAPIを直接叩くわけではありませんが、この分け方はそのまま使えます。いま1つのAIに全部を頼んでいる人は、おそらく2種類以上の仕事を混ぜて渡しています。意図を補ってほしい相談と、画面を見せて直させる作業と、同じ処理の繰り返し。この3つは、Gammaの計測では別のモデルが勝っている仕事です。混ぜて渡しているあいだは、どのAIが自分に合うかという問いにも答えが出ません。
もう一点、公開されたこと自体にも意味があると見ています。モデルの評価はこれまで、提供元の自社発表と第三者ベンチマークの2つに偏っていました。実際に全社へ金を払い、品質を自社の売上で測っている側の記録は、ほとんど表に出てきませんでした。Gammaは定価での集計だと断ったうえで、落としたモデルの名前と理由まで書いています。こういう記録が月次で積み上がるなら、ベンチマークの点数よりは当てになるはずです。
ただし、鵜呑みにはできません。Gammaは自社モデルの開発に乗り出していて、レポートの末尾では、自前のスライド修復モデルが汎用モデルを上回ったという結果を出しています。つまり、このレポートは中立な観測者の記録ではなく、これから競合になる側が書いた記録です。数字の出どころが自社計測である点と合わせて、割り引いて読む必要があります。
Section 07
まとめ
2026年11月16日、スライド生成サービスのGammaが月次レポート「Gamma Model Index」の11月版を公開しました。10月の最終完全週の支出シェアはOpenAIが40%、Anthropicが38%、Googleが9%で、2023年以来はじめてOpenAIが上回っています。逆転が確定したのは10月29日で、GPT-6.1 TerraがClaude Haiku 5.5とClaude Sonnet 5.5から複数の仕事を奪った結果でした。
内訳は仕事ごとに割れています。計画と対話は支出の約42%で78%がAnthropic、依頼ベースの編集は9%で71%がAnthropic。一方スライド修復は14%で97%がOpenAI、画像生成も14%でOpenAIが多数。執筆は17%をOpenAI 61%・Google 30%・Anthropic 10%で分け合っています。
呼び出し回数で数えると順位は裏返ります。GPT-6 Luna・GPT-5.6 Luna・Claude Haiku 5.5の3本が回数の4分の3あまりを占めながら、言語モデル支出では2割台。逆にClaude Sonnet 5.5は10回に1回の呼び出しで支出の36.1%を持っていきます。横並びで測った2つの仕事では、OpenAIのモデルの出力トークンがClaudeより2.6〜4.6倍少なかったという指摘もありました。
数値はすべてGammaの自社計測で、支出は定価での集計です。開発者向けAPIの話なので、ChatGPTやClaudeの個人向け月額プランの価格とは関係しません。
次に動くのは無料プランの会話だ。10月28日から、無料ユーザーのデッキの計画はGPT-6.1 TerraとClaude Sonnet 5.5に半々で振り分けられていて、結果はまだ接近しているという。ここでTerraが勝てば、Anthropicが握っている最大の費目が削られる。負ければ、会話はClaudeのまま残る。答え合わせは12月のレポートに出る。